сентябрь 19, 04:30
Анализ: Бутерин заявил, что локальный ИИ может защищать конфиденциальность без потери скорости
Ethereum co-founder Vitalik Buterin argues that local AI can protect your privacy without losing speed

CryptoSlate
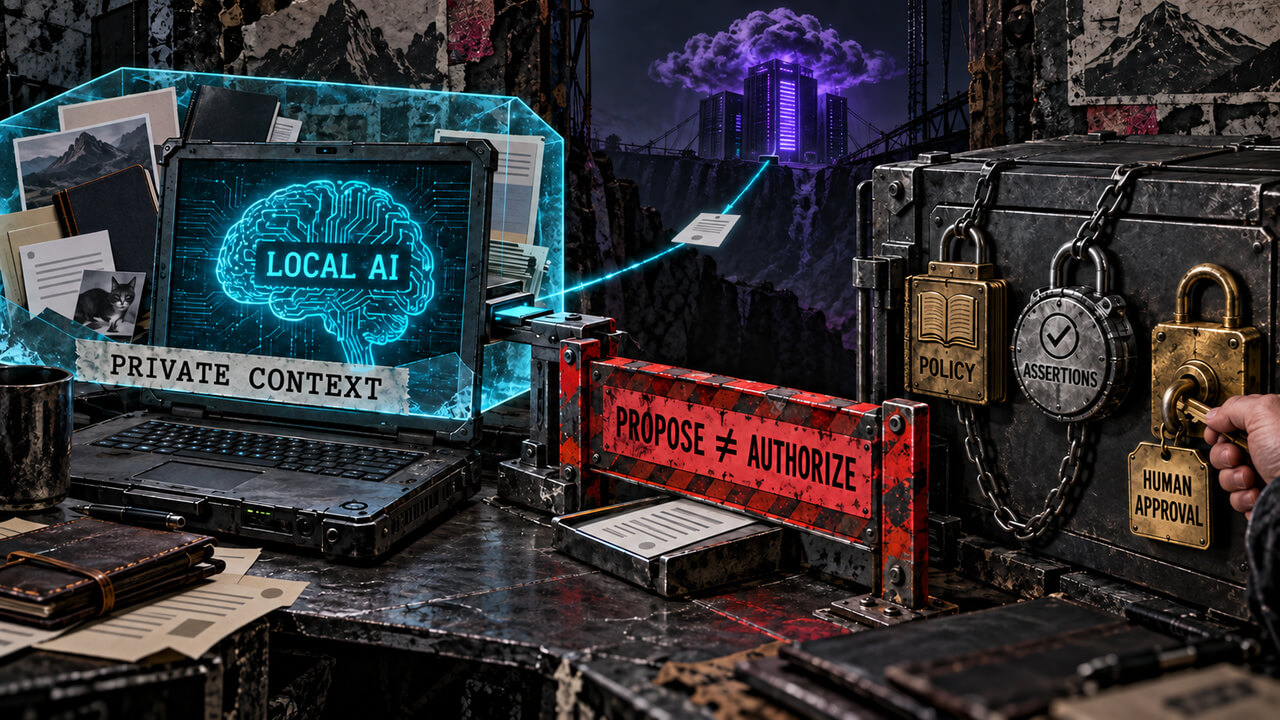
17 сентября Виталик Бутерин заявил, что Qwen 3.8 Flash и недавние улучшения в llama.cpp приблизили локальные модели к способности выполнять значительную долю задач на его ноутбуке Strix Halo. Он описал локальную модель, координирующую запросы к более мощным удалённым системам, но не передающую им полный персональный контекст пользователя. На изображении с результатами тестирования, приложенном к его публикации, были показаны 10 рабочих сценариев: заявленные скорости обработки входных данных составляли от 109,82 до 373,22 токена в секунду, а скорости генерации выходных данных — от 18,42 до 33,37 токена в секунду. Эти показатели подтверждают заявление об отзывчивости на одном высокопроизводительном ноутбуке, но не устанавливают качество суждений модели, её устойчивость к вредоносным инструкциям или способность авторизовывать транзакции. По сравнению с публикацией от апреля сентябрьская оценка Бутерина отводит моделям на ноутбуках более широкую роль, чем расшифровка речи, суммирование и другие строго ограниченные задачи. В более новом описании локальная модель может служить основным интерфейсом для большего числа действий и решать, когда требуется удалённая модель. Удалённый сервис получает только вопрос или контекст, выбранные локальной моделью, а не каждый файл, сообщение и сведения о кошельке из более широкого контекста пользователя. В апрельском и сентябрьском описаниях использовались разные поколения моделей и задачи, а в сентябрьской публикации не были указаны содержимое запросов, варианты квантования и полная конфигурация среды выполнения. В статье Qwen3.8-Flash определяется как мультимодальная модель с открытыми весами и архитектурой смеси экспертов, выпущенная командой Alibaba Qwen. Основная модель насчитывает 125 млрд параметров, а таблицы n-граммных эмбеддингов добавляют ещё 51 млрд; при этом на каждый токен активируются 6 млрд параметров. В официальном репозитории описан локальный запуск текстовых и визуальных запросов через llama.cpp с использованием квантованных сборок GGUF. Активация только части модели для каждого токена снижает вычислительную нагрузку, однако пользователям по-прежнему требуется достаточно памяти для выбранной сборки и контекста. В официальных материалах не указаны единые минимальные требования к оборудованию, применимые ко всем уровням квантования и рабочим нагрузкам. В техническом отчёте Qwen базовая модель оценивается по 14 тестам, охватывающим общие знания, математику, естественные науки, рассуждение, программирование и многоязычное понимание. Команда Qwen сообщила, что Flash-Next превзошла более крупную базовую модель Qwen3.7-Plus в восьми тестах, используя при этом меньше активируемых параметров и меньше вычислительных ресурсов для обучения. Эти тесты охватывают возможности, эффективность и стабильность обучения, но не устойчивость к внедрению вредоносных запросов, соблюдение политик, авторизацию операций кошелька или корректность автономных финансовых действий. Ассистент может конфиденциально объяснить транзакцию, подготовить calldata или предложить маршрут, тогда как подписывающее устройство может сформировать необратимый запрос, переводящий активы или предоставляющий другому контракту разрешение на их перемещение. Вредоносные инструкции, скрытые на веб-сайте, в сообщении или описании транзакции, по-прежнему могут перенаправить план модели. Во втором квартальном обновлении распределения средств Ethereum Foundation был указан Steward — полностью локальный кошелёк умного аккаунта для macOS, лёгкий клиент и ИИ-ассистент которого должны работать на устройстве. Эта информация подтверждает финансирование и масштаб проекта, но не свидетельствует о запуске в рабочей среде, наличии независимого аудита или автономных полномочиях по проведению транзакций. В апрельских рекомендациях Бутерина по кошелькам политика выводилась за пределы языковой модели с помощью межсетевого экрана, требующего подтверждения человеком для рискованных действий, детерминированных ограничений на суммы транзакций, calldata и число транзакций, а также правила 2 из 2 с участием человека и модели. Автоматизация операций с низким риском может сохраняться в пределах разрешений, заданных программным обеспечением, например при чтении балансов, подготовке неподписанных транзакций или работе в рамках жёстко ограниченных лимитов. EIP-7906 остаётся проектом и предлагает фреймы утверждений после транзакции, проверяющие итоговые изменения состояния, созданные транзакцией. Утверждение может отклонить результат, если он нарушает заданное условие, например изменяет не одобренные балансы, создаёт скрытое разрешение на использование токенов или обращается к защищённому аккаунту. В статье отмечается, что утверждение, проверяющее слишком малый объём данных, может создать ложное чувство безопасности, поэтому логика валидации кошелька должна требовать предусмотренный фрейм утверждения, а само утверждение должно охватывать каждое существенное изменение состояния. Локальный запуск моделей и утверждения транзакций решают разные части проблемы кошелька с агентом. Локальная модель защищает контекст и преобразует намерение, выраженное на естественном языке, в предлагаемое действие; детерминированные разрешения ограничивают получателей, контракты, стоимость и частоту операций; утверждения проверяют итоговые изменения состояния, а подтверждение человеком остаётся вторым фактором для рискованных действий. Результат на ноутбуке делает слой локальной модели более убедительным для быстрой координации и выборочного использования удалённого интеллекта, но полномочия по распоряжению активами по-прежнему остаются у средств контроля, которые модель не может изменить, и у процедуры одобрения, сохраняющей за пользователем реальный контроль.
This content is an AI-generated summary/analysis for informational purposes only and does not constitute investment advice.