10月 10, 18:00
コインベースの評価、AI主要モデル3系列で新型の決済不正検知が低下
Newer AI models missed more payment fraud in Coinbase's benchmark

CryptoSlate
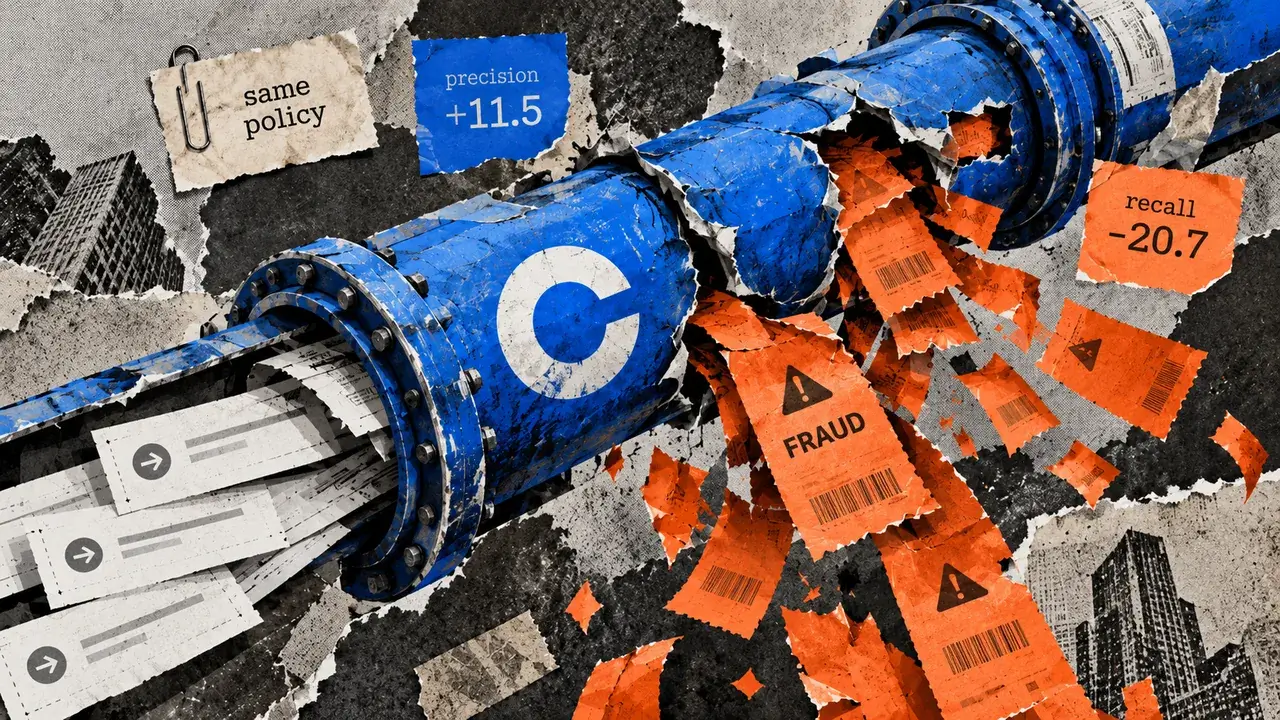
コインベースは10月7日、同社のOnrampサービスを対象とした過去のテストで、主要なAIモデル3系列の新しいバージョンは不正な決済の検知件数が少なかったと報告した。変更していない判定方針のもとでも、新しいバージョンが検知した不正取引額の割合は低下した。この結果は、モデルを更新すれば既存の決済審査機能が改善するという前提に疑問を投げかける。
コインベースの評価では、7293人の利用者による1万6140件の取引を再現し、うち813件は不正と確認されていた。対象期間は、コインベースのリスクエージェント導入前の9週間だった。この対象群には、判定が確定したすべての不正事例を含める一方、正当な取引は抽出して含めた。各候補モデルは、固定された指示と、リスク分類を判定に変換する共通の方針のもとで、直近の取引行動を評価した。この設定により、審査システムを再設計して比較するのではなく、判定モデルの挙動を切り分けて検証した。
コインベースは、Opus 4.5とOpus 5、Sonnet 4.6とSonnet 5、GPT-5.4とGPT-5.6 (sol)を比較した。新しいバージョンはいずれも再現率、F1スコア、金額加重再現率が低下した。再現率は不正事例のうち検知した割合を示し、金額加重再現率は不正取引額全体のうち検知した割合を示す。F1スコアは適合率と再現率を組み合わせた指標だ。
コインベースの再現テストでは、Sonnetの再現率が22.2ポイント、金額加重再現率が22.9ポイント低下した。Opusの再現率は0.8ポイント低下した。新しい2つのモデルはいずれも適合率も低下した。つまり、不正と判定された取引のうち、実際に不正だった割合が小さくなった。GPTの適合率は11.5ポイント上昇した。一方、GPTの再現率は20.7ポイント、金額加重再現率は21.8ポイント低下した。GPTの不正判定の正確さは高まったが、より多くの不正事例と不正取引額を検知できなかった。
この再現テストは、これらのバージョンを導入した場合に顧客に損失が生じることを示すものではない。コインベースは、こうした性能低下を特定できたものの、その原因は特定できていないと述べた。同社が先に実施したオンライン実験では、大規模言語モデル(LLM)による選択的な審査と、既存モデルとルールのみを使う方法を比較した。エージェントを使った処理では、不正取引の件数が30%、不正取引額が22%減少した。このオンライン実験では新しいモデルのバージョン同士は比較していない。SR-Fraudの研究者らは、独自データセットを公開できないため、第三者による再現と一般化が制限されると述べた。研究者らによる関連する決済不正の研究は9月23日に初めて公表され、10月のブログ記事に先立つ9月30日に改訂された。
コインベースは10月8日、追加学習したQwen3.5-9Bモデルが不正検知の4指標すべてでOpus 4.5を上回ったと報告した。同社によると、F1スコアは9.6ポイント改善し、金額加重再現率は35.4ポイント上昇した。コインベースは、過去の不正結果と、不正・正当な事例のバランスを取る決定論的な報酬を用いて独自モデルを特化させた。
本番環境での別個の測定では、LLMリクエストのエンドツーエンドの中央値レイテンシーは0.683秒で、Opus 4.5の1.515秒に比べて相対的に55%低かった。推論の高速化とベンチマークでの検知性能向上は、別々の評価で得られた結果だ。いずれの評価も、検証対象となったモデルの更新による顧客損失を測定していない。
決済事業者にとって、モデル更新の判断で問われるのは、各社の実際の判定設定のもとで候補モデルが不正検知範囲を改善するかどうかだ。コインベースは、まずその設定でテストし、プロンプトや閾値を変更した場合は別途評価するよう推奨している。同社は、検知品質と合わせてレイテンシー、信頼性、コストも評価するよう勧めている。
This content is an AI-generated summary/analysis for informational purposes only and does not constitute investment advice.